一家欧洲研究机构在网页上输入问题,几秒钟后收到中国企业研发的模型生成的英文答案。计算可能发生在中国,也可能发生在新加坡或欧洲。模型可能来自中国企业,提供算力、签署合同、接触数据和收取费用的,却未必是同一家机构。
如果只看屏幕,这几次服务几乎没有区别;如果研究它们的产业价值和合规要求,答案会很不一样。
“Token出海”因此值得认真讨论。它描述了人工智能能力跨境交付的一种商业现象,但不能替代对数据、模型、设施和经营主体的分别判断。对政府部门、大学和研究机构而言,首先需要回答的是:谁在何处,利用哪些资源,为谁提供什么服务,并由谁承担责任?
一、先理解Token,才能讨论出海
在大语言模型中,Token通常指模型处理文本的基本单位。它可能是一个词、词的一部分、一个字符或其他片段,具体取决于分词方法。同一句话在不同模型中,Token数量可能不同。这里的Token也不是区块链代币。[1]
很多模型服务按输入和输出的Token数量计费。因此,人们用“Token出海”概括中国企业向海外提供模型推理服务。但现实中的交易还可能按GPU使用时长、专属集群、软件许可、项目交付或订阅收费,不能全部换算成同一种产品。
还要澄清一个技术误解:把文字转换成Token编号,并不会自动实现匿名化。 普通分词编码服务于模型输入与解码,本身不是隐私保护承诺。一份包含姓名、病史或访谈记录的材料,经过分词后,仍需判断是否能够识别个人。中国《个人信息保护法》区分去标识化与匿名化;能否重新识别、是否不可复原,比文件看起来是不是自然语言更关键。[1][2]
从合规角度看,问题不在于传输单位叫“文字”“向量”还是“Token”,而在于其中包含什么信息,以及接收方实际上能够做什么。
二、三条路径,形成三种不同的出海业务
第一条:算力留在中国,向海外交付服务。 海外用户通过程序接口,也就是API,发送请求;境内服务器完成推理,再把结果返回。这里的重点是跨境服务与双向数据流,不一定发生服务器或模型权重的出口。
第二条:在海外部署算力,由当地节点提供服务。 中国关联企业自建、租用或与伙伴共同运营境外设施。此时要考察设备取得、当地经营、能源网络、数据处理和集团运维。海外机房能改善部分交付条件,却不会自动解决芯片供应限制、远程访问或当地采购要求。
第三条:中国模型由海外机构运行。 研发商提供模型权重或软件,海外云、大学或企业自行部署。权重是模型学习形成的参数;取得权重,并不等于取得训练数据或获得不受限制的使用权。这条路径可以扩大中国模型的采用范围,但算力收入可能由海外云获得,模型研发商是否获得许可费或服务费,要看实际合同。
这三条路径分别体现服务交付、海外基础设施运营和模型传播。中国模型被使用、由中国企业提供计算、收入归属于中国企业,是三个需要分别统计的事实。 海外调用量也不能直接当作服务出口收入;正式统计和国际收支归类仍须结合交易主体、居民身份、收费性质及适用统计制度。
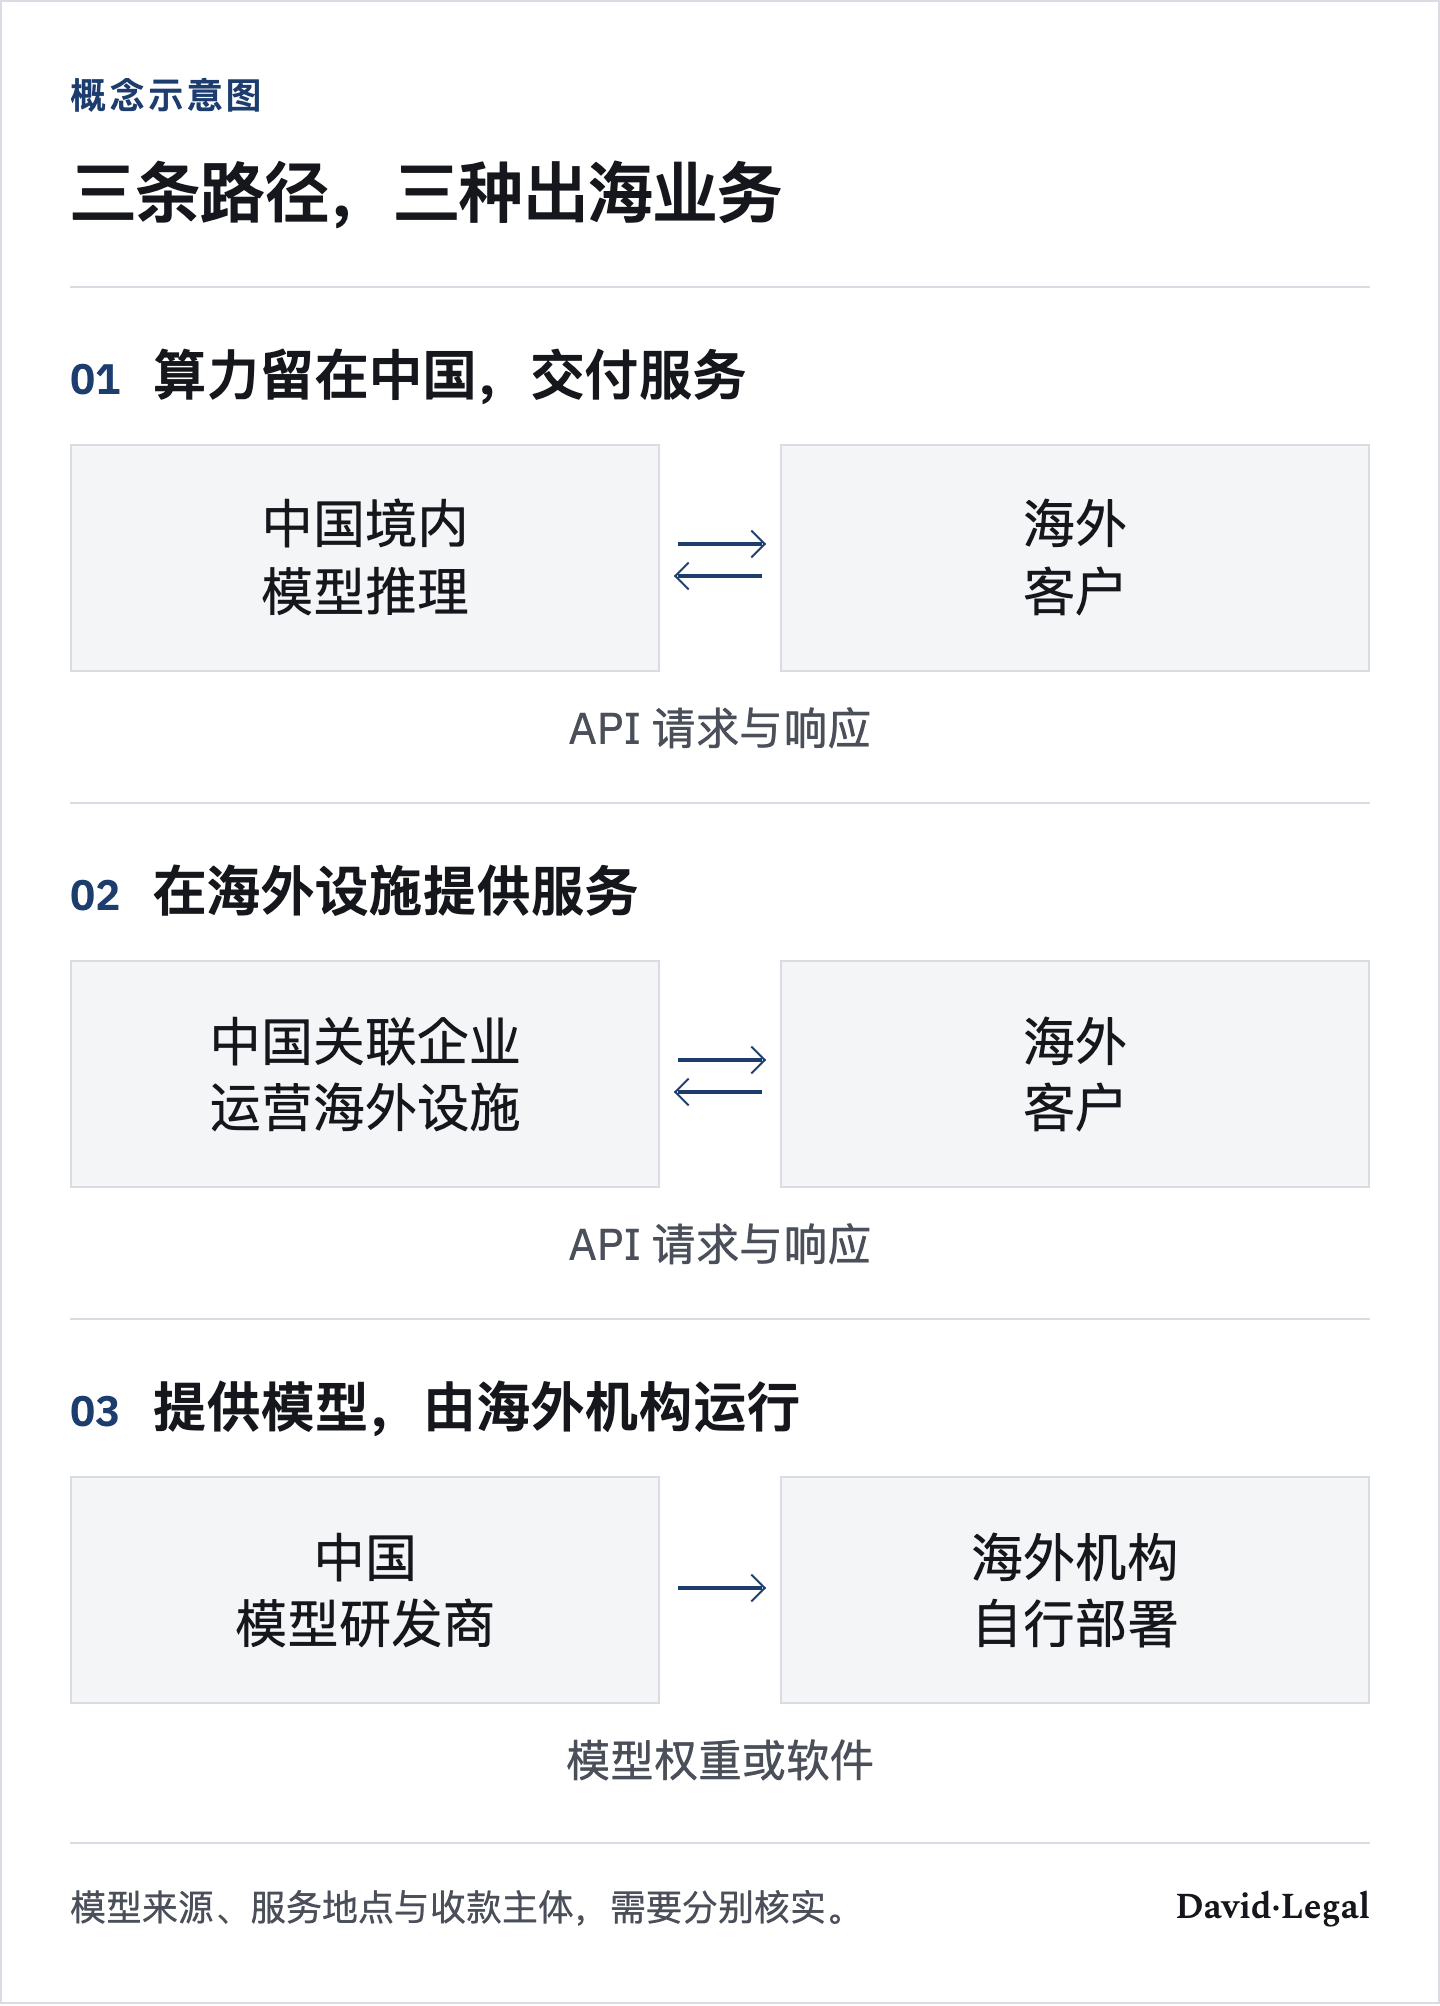
David·Legal原创示意,依据第二节。图示为可能的交付安排,不代表任何供应商的固定部署地点。
三、数据走到哪里,要沿一次请求追踪
设想一所大学采购“海外部署”的模型服务。它上传论文初稿,模型调用文献检索工具,平台保存运行日志,供应商客服随后从另一国家排查错误。看似一次请求,实际涉及文稿、检索内容、账号、日志和运维访问等多条数据流。
因此,一张有用的数据图至少要标明:请求从哪里进入、在哪里推理、在哪里存储和备份、由谁远程访问、是否进入人工审核或模型训练,以及删除如何执行。
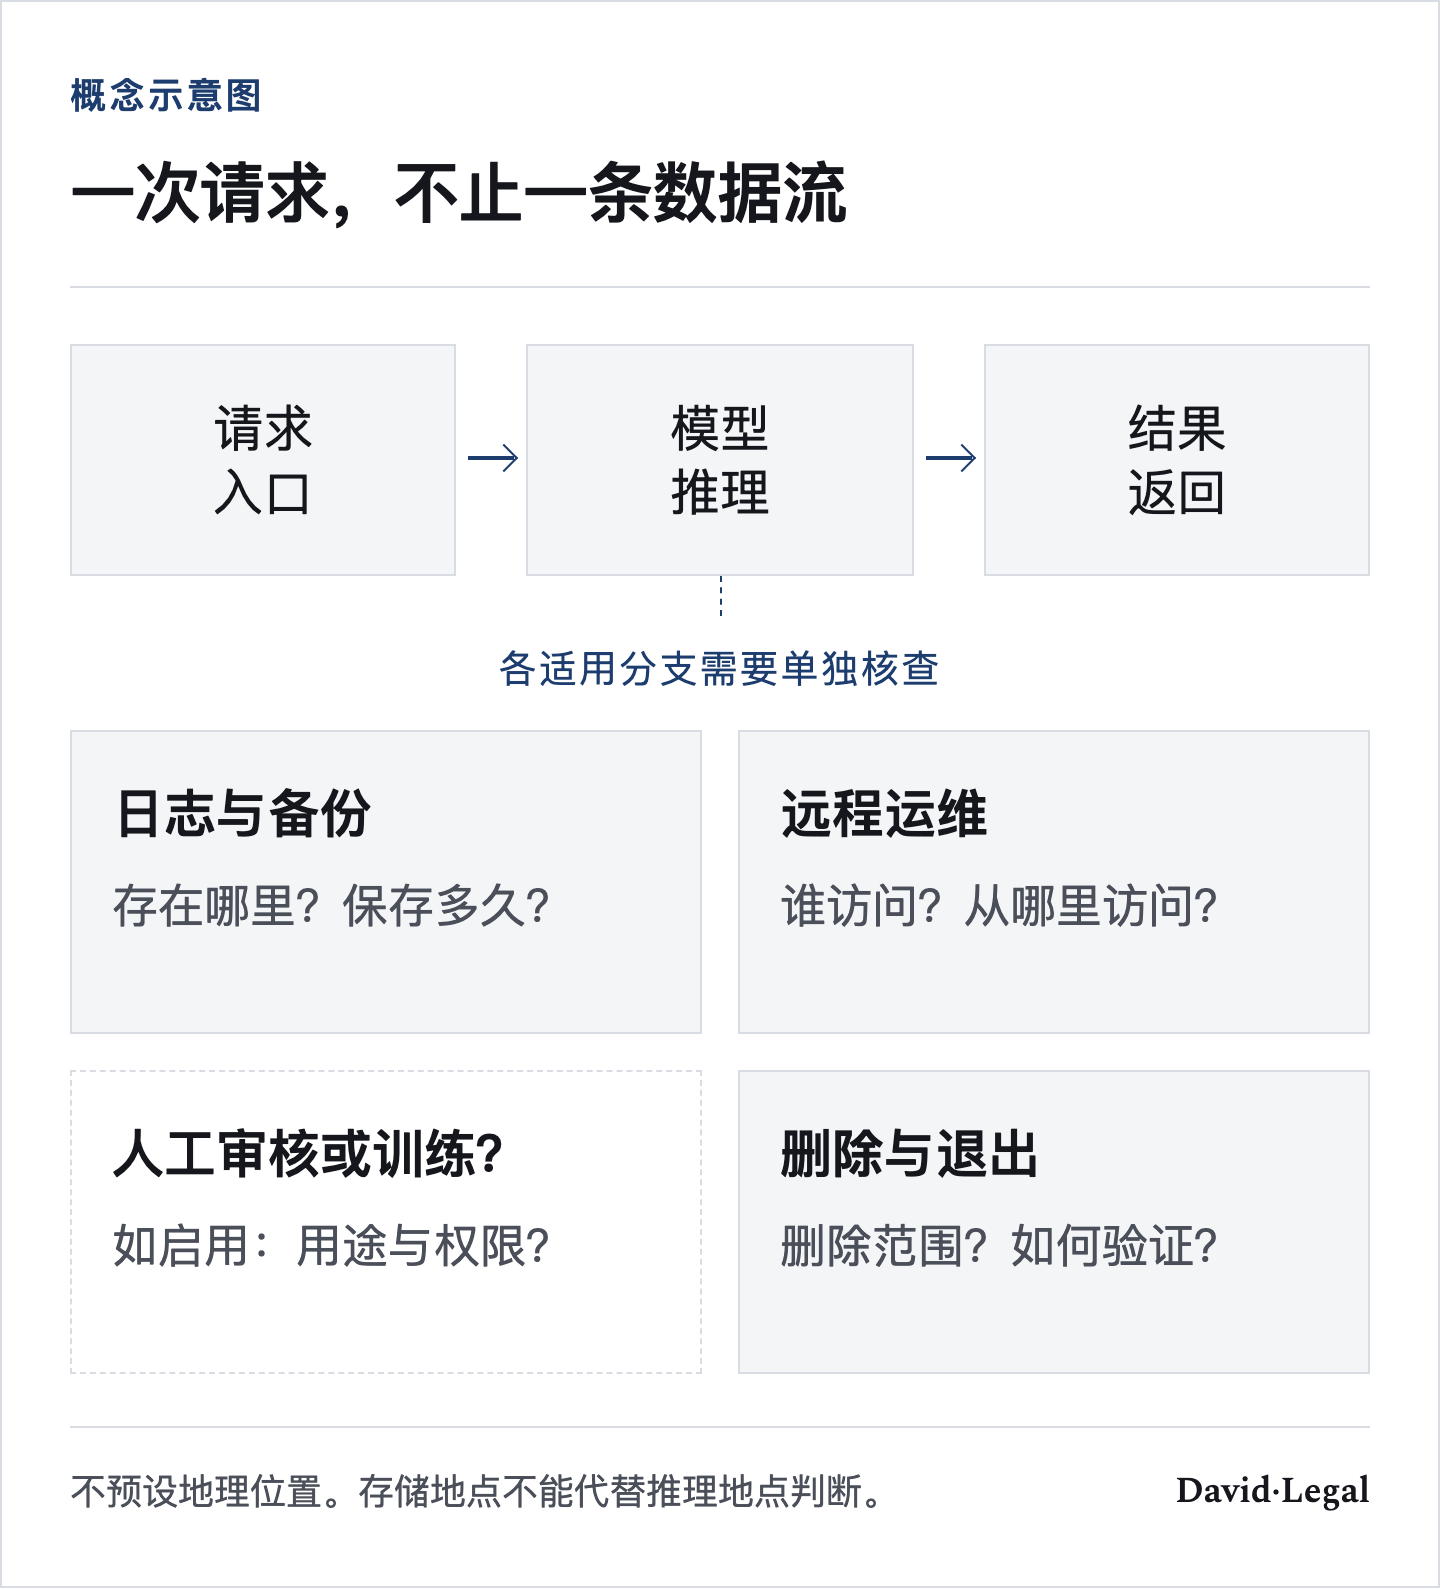
David·Legal原创示意,依据第三节。存储Region不等于推理地点;审核或训练需确认是否启用,删除需验证实际执行。
这不是抽象的担忧。阿里云Model Studio的官方文档明确区分:Region决定接入点与数据存储地点,服务部署范围决定推理执行地点。以法兰克福为例,文档列有Global与EU两种范围。采购方需要确认所选配置,不能仅凭“欧洲Region”推断所有计算均在欧洲。[3]
在欧盟制度下,是否发生个人数据向第三国转移,还需要结合实际接收主体、提供访问的方式及法律关系判断。中国母公司或独立支持机构能够读取数据,是应当单独审查的事实;不能只用服务器地址代替分析,也不宜把所有跨境登录一律作相同定性。[4]
中国规则也提供了有针对性的便利安排。《促进和规范数据跨境流动规定》第四条规定,境外收集和产生的个人信息传入境内处理后再向境外提供,如果过程中没有引入境内个人信息或重要数据,可免予申报数据出境安全评估、订立个人信息出境标准合同、通过个人信息保护认证。[5]
这项安排针对的是三项出境机制,不等于免除全部个人信息保护义务,也不替代数据来源地的法律要求。 例如,欧洲机构把个人数据送到中国处理,仍须处理其自身适用的欧盟数据保护要求。
四、数据合规之外,还有三组责任
其一,内容和应用责任。 纯机房托管、提供模型API、开发模型,以及面向公众运营聊天产品,对功能、数据和用户的控制不同。面向企业销售API,并不意味着下游不会用于招聘、信贷、教育或医疗;终端用途可能改变适用规则。
中国《生成式人工智能服务管理暂行办法》以向境内公众提供相关服务为适用入口,并明确了未向境内公众提供服务的研发、应用活动的范围边界。科研机构的内部实验与向公众开放的产品,应分别判断;不适用该办法,也不能进一步推导为不受数据、知识产权或其他法律约束。[6]
欧盟则区分通用人工智能模型提供者、系统提供者和部署者等角色。对落入相应范围的模型提供者,版权政策、训练内容摘要和向下游提供文档等义务,不能由一张云服务订单替代。也不能反过来把所有GPU出租商都当作模型研发商。[7]
其二,知识产权责任。 模型能够下载,不代表权重、代码、训练材料、客户上传内容和生成结果共享同一套权利。公开发表的论文也不当然可供任意复制、训练和商业再利用;订阅数据库还涉及合同限制。研究项目应把文献检索、模型训练、成果发表和商业合作所需权限分别核实。[8]
开放许可应落实到具体版本。DeepSeek-R1官方仓库对代码和权重作出许可说明,同时列出蒸馏模型的上游来源及许可。这说明“模型可商用”只是审查的起点,不能覆盖所有衍生模型和第三方权利。[9]
其三,设备与安全责任。 芯片能否取得、转移或用于特定主体,与一项服务能否销售给某类客户,是不同问题。BIS的相关指引表明,把实体设在指定地区之外,仍可能因其总部或最终母公司的所在地而触发先进计算物项的许可要求;具体设备和交易须另查现行规则。美国数据安全项目则针对特定数据、主体和交易设置限制。两者不能用“机房已经在海外”一并解决,也不能据此断言所有中国企业面向美国提供的模型服务均被禁止。[10][11]
五、同样是科研合作,数据和功能可能改变结论
以下是用于解释的假设情景,不是对实际项目的合规认定。
情景A:海外高校在自己的集群部署中国开放权重模型,只用经过权利审查的公开材料开展内部研究。 如果推理、日志和管理权限确实留在本地,不能仅因模型来自中国,就认定提示词已传回中国。应继续核实许可证、依赖组件、更新与遥测、远程支持,以及研究成果的后续使用。
瑞典皇家理工学院并行计算中心,摄于2010年12月9日。仅作基础设施参考,并非中国供应商或当前AI集群的照片。Johan Fredriksson (Esquilo), Wikimedia Commons · CC BY-SA 3.0。原图未作修改。

情景B:联合课题组把可识别的受试者访谈或健康资料,交给跨国API进行分析。 此时,个人信息处理依据、告知与同意的适用要求、伦理审查、目的限制、跨境路径和后续训练用途,都可能成为核心问题。合同写了“不用于训练”,也未回答在哪里推理、保存多久、谁能访问、是否调用其他工具。
如果同一系统进一步参与公共资助、入学、就业或医疗等对个人产生显著影响的决定,还需要重新判断场景规则。不能把“学术研究”的项目名称作为覆盖后续公开服务和实际决策的统一豁免。
六、政府与研究机构可以把问题落到四份材料
以下是面向产业研究、项目组织和采购评估的建议,不是新增的法定申报清单。
第一份是业务与价值分配图。 谁拥有设施、开发模型、提供推理、面对最终用户、签约收款?把海外客户数量、实际推理量、可归属收入、服务持续性和当地合作分别记录。在比较Token单价之前,先固定模型版本、语言、输入输出比例、质量要求与服务保障,避免把不同产品当作同一种商品。
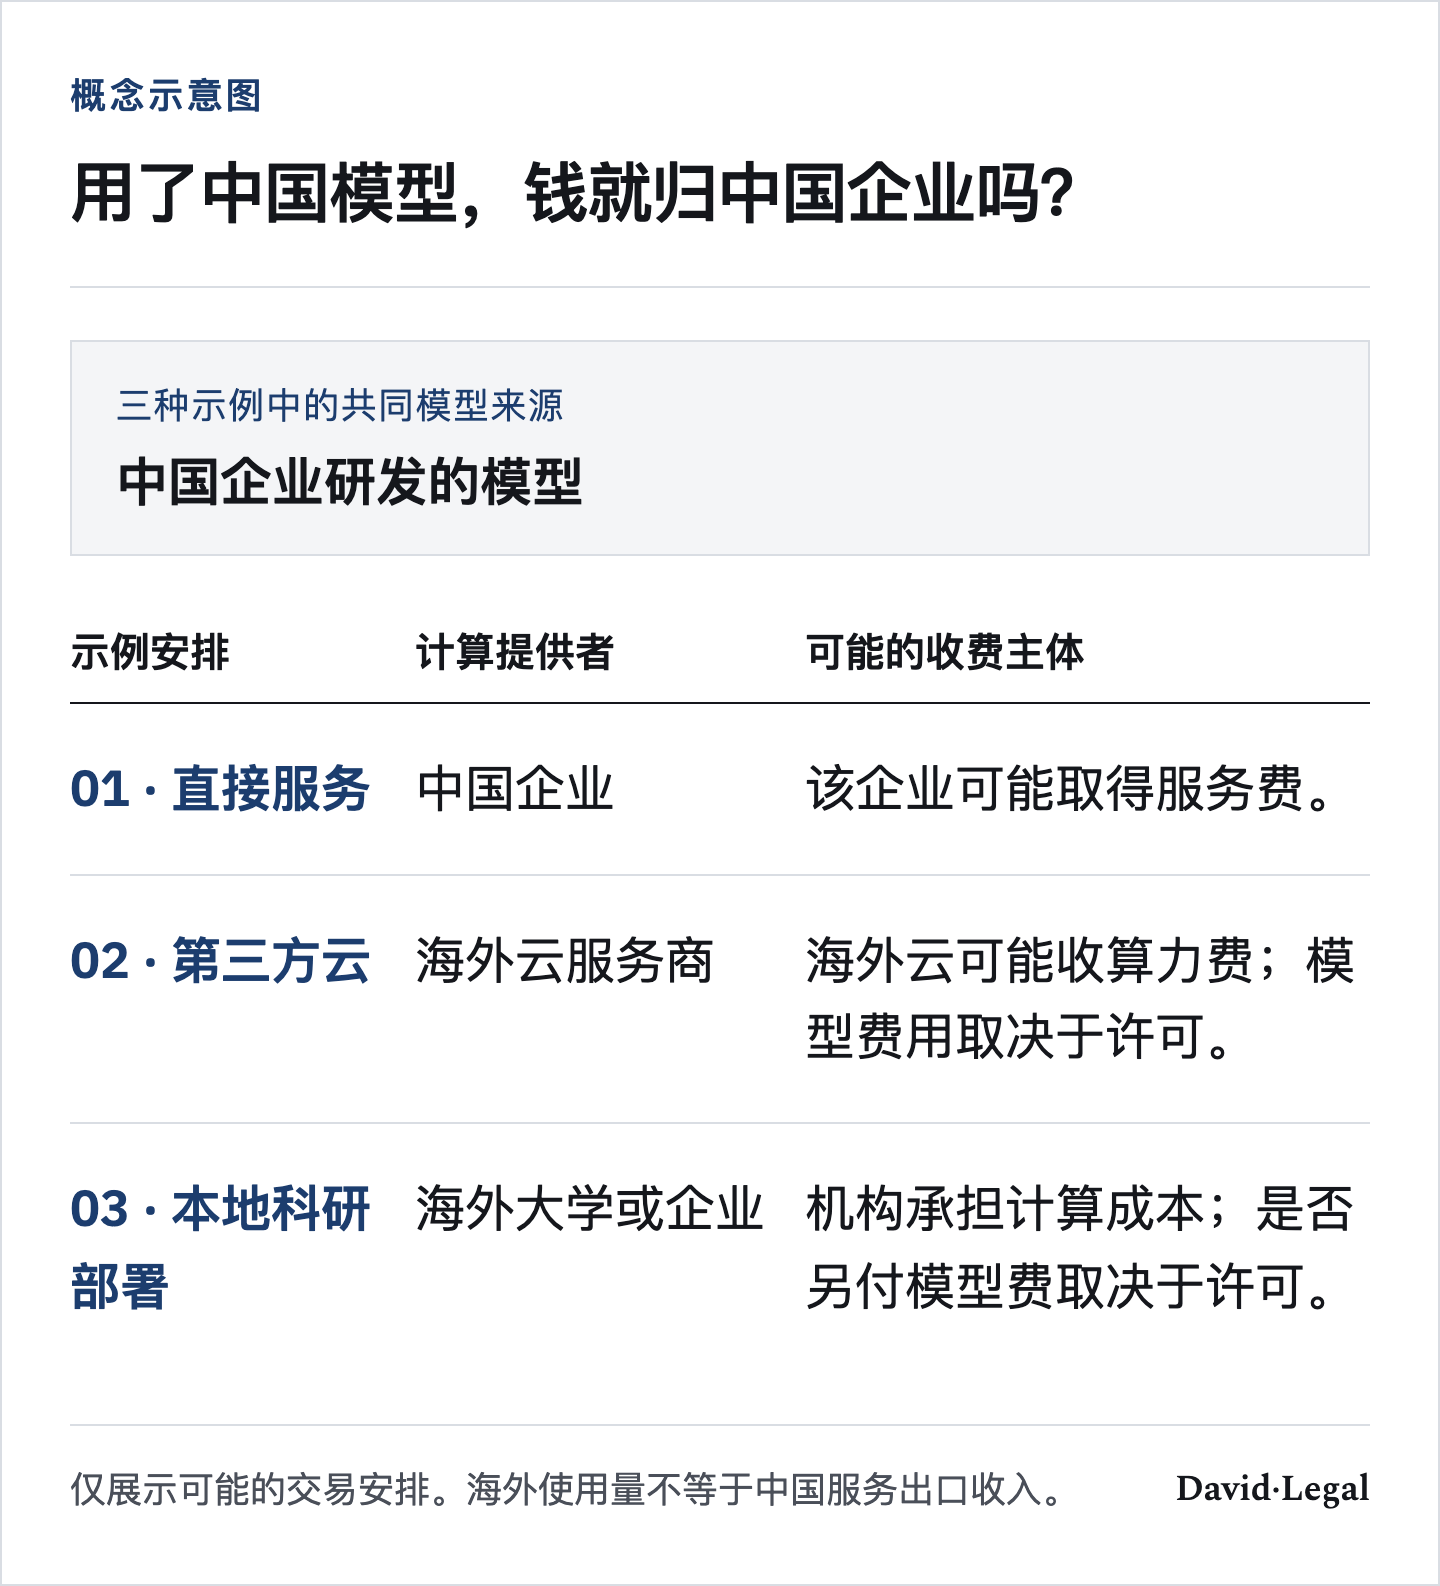
David·Legal原创比较图,依据第二、六节。仅展示可能的收费安排,不表示市场份额或实测营收;收款还需另作会计归属与贸易统计判断。
第二份是数据与权限图。 逐项列出研究材料、个人信息、日志和备份的位置,以及人员、集团公司和分包商的访问权限。对依法需要保密或限制提供的数据,应先判断可否进入该系统,再讨论成本和效率。
第三份是权利与责任表。 记录训练及研究材料的权利来源、模型许可版本、研究成果归属、发表与再利用条件,明确谁响应数据请求、内容投诉、安全事件和知识产权争议。
第四份是可复核的交付记录。 保留区域配置、实际路由和访问证据、版本变更、评测方法、删除与退出安排。涉及时效、准确性或公共决策的场景,还要说明由谁复核,以及结果错误时怎样纠正。
这些材料使监管、采购、科研管理和技术团队能够讨论同一个项目事实。地区认证、合同条款和行业标准仍有价值,但应说明它们覆盖什么、由谁验证、有效期多久,而不是把“获得认证”替代为整体合规结论。
七、国际合作应让证据更容易被理解和核验
跨境AI服务会同时面对不同语言、法律和审查习惯。国际合作的实际价值,可以体现在数据处理条款的衔接、模型文档、评测方法、事件沟通和监管能力建设上。
例如,东盟与欧盟已发布模型合同条款的联合对照指南,帮助理解两套工具之间的关系。它可以降低合同协调成本,却不意味着采用其中一套条款,就自动满足另一法域的全部要求。[12]
对政府和学术机构而言,可推动的工作包括:使用透明且可复现的评测口径,建立可比较的交付说明,研究不同跨境机制的衔接条件,并让监管与技术人员共同检验这些材料。试点项目仍应在现行法律和实际授权范围内运行,合作倡议本身不会创设豁免。
结语:让一次调用成为可以持续交付的服务
“Token怎么走出去”的答案,最终要落在一条可说明、可验证、可追责的服务链上:能力由谁提供,数据如何流动,权利从何而来,结果用于哪里,出现问题由谁处理。
研究这种出海能力,既要观察模型和设施,也要观察收入归属、组织能力与当地交付条件。能把这些问题讲清楚,才能判断一次海外调用,是否正在形成可持续的产业价值。
资料与出处
本文面向政府部门与学术研究机构作一般性合规科普,基于《中国AI基础设施出海》研究底稿改写;主要引文于2026年9月25日复核。建议和假设情景均不代表监管机关结论,也不替代具体项目的法律、伦理或采购审查。
- Hugging Face:Tokenization algorithms。解释文本分词;不据此推定匿名化。
- 《中华人民共和国个人信息保护法》,第四条、第七十三条等。
- 阿里云Model Studio:Regions and endpoints。厂商动态产品文档;证明其公开配置说明,不是独立合规认证。
- EDPB:Guidelines 05/2021。解释GDPR域外适用与第三国转移的关系。
- 《促进和规范数据跨境流动规定》,第四条。
- 《生成式人工智能服务管理暂行办法》,第二条。
- 欧盟委员会:通用人工智能模型提供者义务指引问答。适用仍须结合模型、角色和有关过渡安排。
- WIPO:Generative AI—Navigating intellectual property。企业采用生成式AI的知识产权问题指南。
- DeepSeek-R1官方仓库:许可与蒸馏模型说明。应以实际部署版本为准。
- 美国BIS:先进计算相关指引,2026年5月31日。具体设备和交易仍需核查现行规则及许可。
- 美国司法部:Data Security Program。特定数据、主体和交易的适用框架。
- ASEAN—EU模型合同条款联合指南。合同工具对照,不是法律互认或一般市场准入许可。